馬斯克旗下 xAI 於週一下午發布 Grok 4.7,稱其為迄今表現最佳的模型,並表示它「在相同價格與速度下,相較 Grok 4.6 有顯著提升」。
這次發布之前曾多次明顯延後。自 7 月下旬以來,馬斯克至少五度調整時程:先說「還要四週」,接著變成「還要幾週」,之後是「3 到 4 週」,9 月 1 日又改口成「10 天」,到了 9 月 11 日則表示「還需要再多煮幾天」。
xAI 表示,與 Grok 4.6 相比,新模型在處理困難問題時會花更長時間推理,也更頻繁地重新檢查自身答案,同時搭載公司所稱迄今最強的安全防護機制。
馬斯克隨後也在 X 上發文,稱 Grok 4.7 是「智慧、速度與低成本的強力組合」。這次沒有候補名單——目前已在 Grok app、Cursor、Grok Build 與 xAI API 直接上線。
Grok 4.7 已登場。
在相同價格與速度下,它較 Grok 4.6 有顯著進步。pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 2026 年 9 月 21 日
Grok 4.7 擁有 2.1 兆個參數,較 Grok 4.6 的 1.5 兆增加了 40%;而 Grok 4.6 本身則是 Grok 4.5 的改良版本。其定價為每百萬輸入 token 2 美元、每百萬輸出 token 6 美元。參數是模型在訓練過程中調整的內部權重,數量越多通常代表學習模式的能力越強;而 token 則是 AI 模型能夠接收或生成的基本資訊單位。
xAI 還納入了來自馬斯克火箭公司 SpaceX 的補充訓練數據,包括 Starlink 衛星遙測資料、製造紀錄,以及工程故障日誌。其賣點在於,這將讓模型在硬體與實體系統推理上,優於那些僅以網際網路文本訓練出的模型。
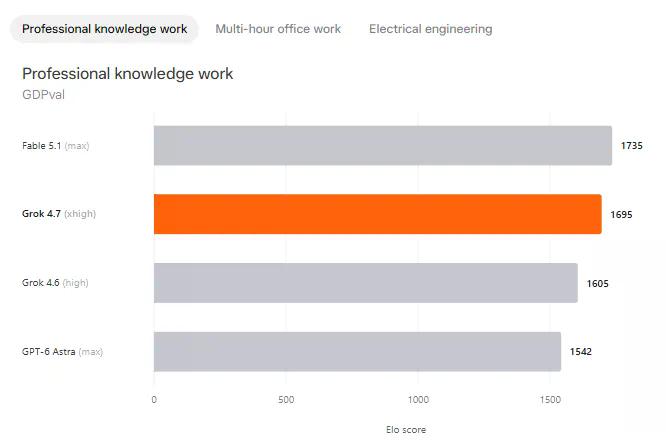
話雖如此,各項基準分數講述的仍是熟悉的故事。GDPval 用來衡量模型在真實且具經濟價值的知識型工作中的表現——例如法律備忘錄、試算表與簡報——其任務由各領域在職專業人士審核,並採用 Elo 等級分制度評分,也就是西洋棋常用的對戰排名系統。
Grok 4.7 在 GDPval 上拿下 1695 分。Claude Fable 5.1 以 1735 分位居榜首。
由 Artificial Analysis 建立的 AA-Briefcase,測試的是可持續數小時的辦公室工作流程,將研究、分析與文件生成串成單一長任務,同樣採用 Elo 制評分。Grok 4.7 得分為 1657,對比 Fable 5.1 的 1678。結果相同,只是測試不同。
CursorBench 4.0 是 Cursor 針對其編輯器內真實程式設計任務的基準測試,將準確率與每項任務消耗的成本及 token 數量一併呈現。Grok 4.7 位居中段:單一任務成本高於 GPT-5.6 Sol 的後繼模型 GPT-6 Astra 以及 Claude Sonnet 5,但仍落後於 Fable 5.1,後者在圖表上的各個價格區間都勝出。
這對 xAI 來說並非新模式。Grok 4.5 於 7 月推出時,背靠業界最大的訓練叢集,但分數仍落後 Claude 與 OpenAI 的模型,排名第三。更早之前,Grok 4.20 以可靠性換取速度與個性;Grok 4.6 在程式設計自主性方面也同樣落後第一梯隊。
這一切並不代表 Grok 4.7 對於數百萬透過 X、獨立 app 或 Tesla 儀表板與其互動的用戶而言,是個糟糕的產品。它意味著,那個最有可能回答你問題、或驅動你車載語音助理的模型,實際運行在一套依照其開發方自家基準測試來看,仍比頂尖水準低一個階梯的系統上。
這個差距也解釋了,為何對大多數人而言,價格標籤比排行榜名次更重要。xAI 一直在每 token 成本上壓低價格、低於 Anthropic 與 OpenAI,儘管其原始能力仍稍遜一籌;其押注的是,對絕大多數日常使用場景而言,「夠好、便宜、無所不在」會勝過「最好、但更貴」。
馬斯克在發布前幾天其實已先降低外界預期,稱 Grok 4.7 應會「大致與」Anthropic 的 Claude Opus 5.0 持平,而不是更新的 Opus 5.1,且多模態表現仍有待加強。
在同一則貼文中,他也勾勒出接下來三個版本:Grok 4.8 將是一次具意義的升級,Grok 4.9 將進入「Astra/Fable 等級」,而 Grok 5 則可能成為前沿領先者。不過,這些升級目前都尚未有發布日期。「我們拭目以待,」他寫道。