xAI متعلق به ایلان ماسک بعدازظهر دوشنبه Grok 4.7 را منتشر کرد؛ مدلی که تا امروز بهترین مدل این شرکت به شمار میرود و از آن بهعنوان «بهبودی قابلتوجه نسبت به Grok 4.6 با همان قیمت و سرعت» یاد شده است.
این عرضه پس از چندین تأخیر ظاهری انجام شد. ماسک از اواخر ژوئیه دستکم پنج بار زمانبندی را عقب برده بود: ابتدا «چهار هفته دیگر»، سپس «چند هفته دیگر»، بعد «۳ تا ۴ هفته»، سپس در ۱ سپتامبر «۱۰ روز» و در نهایت در ۱۱ سپتامبر گفت «چند روز دیگر زمان نیاز دارد تا جا بیفتد».
xAI میگوید این مدل برای حل مسائل دشوار زمان بیشتری صرف میکند و نسبت به Grok 4.6 دفعات بیشتری پاسخهای خود را دوباره بررسی میکند؛ در کنار آنچه شرکت از آن بهعنوان قویترین سازوکارهای ایمنی خود تا به امروز یاد میکند.
ماسک سپس در X نوشت که Grok 4.7 «ترکیبی قدرتمند از هوش، سرعت و هزینه پایین» است. این بار دیگر خبری از فهرست انتظار نیست — این مدل اکنون در اپلیکیشن Grok، Cursor، Grok Build و API xAI در دسترس است.
Grok 4.7 is here.
It's a notable improvement over Grok 4.6 at the same price and speed. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) September 21, 2026
Grok 4.7 دارای ۲.۱ تریلیون پارامتر است؛ رقمی که نسبت به ۱.۵ تریلیون پارامتر در Grok 4.6، که خود نسخهای بهبودیافته از Grok 4.5 بود، ۴۰٪ افزایش نشان میدهد. هزینه استفاده از آن ۲ دلار به ازای هر یک میلیون توکن ورودی و ۶ دلار به ازای هر یک میلیون توکن خروجی است. پارامترها همان تنظیمات داخلی هستند که مدل در طول آموزش آنها را بهینه میکند و افزایش تعداد آنها معمولاً به معنای ظرفیت بیشتر برای یادگیری الگوهاست؛ در حالی که توکنها واحد پایه اطلاعاتی هستند که یک مدل هوش مصنوعی میتواند دریافت یا تولید کند.
xAI همچنین دادههای آموزشی تکمیلی استخراجشده از SpaceX، شرکت فضایی ماسک، را نیز به مدل اضافه کرده است: تلهمتری ماهوارههای استارلینک، سوابق تولید و لاگهای خرابی مهندسی. ادعای اصلی این است که مدل جدید در استدلال درباره سختافزار و سامانههای فیزیکی بهتر از هر مدلی عمل میکند که صرفاً بر اساس متن اینترنت آموزش دیده باشد.
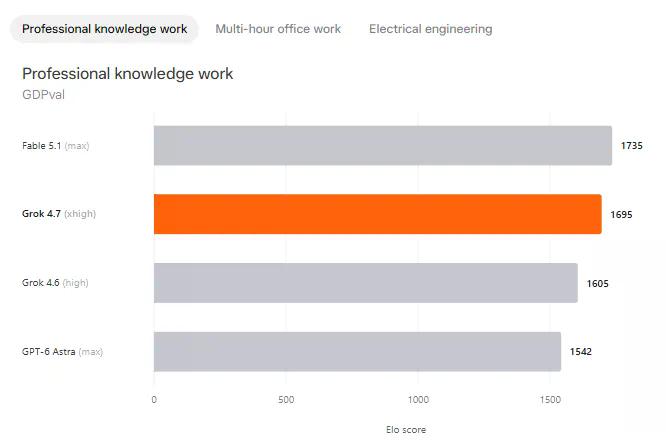
با این حال، امتیازهای بنچمارک روایت آشنایی را بازگو میکنند. GDPval میسنجد که یک مدل در کارهای دانشی واقعی و دارای ارزش اقتصادی — مانند یادداشتهای حقوقی، صفحات گسترده و اسلاید دک — چگونه عمل میکند؛ این ارزیابی با استفاده از وظایفی انجام میشود که متخصصان فعال هر حوزه آنها را تأیید کردهاند و نتیجه بهصورت رتبه Elo گزارش میشود؛ همان سیستم رتبهبندی رودررو که در شطرنج استفاده میشود.
Grok 4.7 در GDPval امتیاز ۱۶۹۵ را ثبت کرد. Claude Fable 5.1 با امتیاز ۱۷۳۵ در صدر جدول قرار گرفت.
AA-Briefcase که توسط Artificial Analysis ساخته شده، کارهای اداری چندساعتهای را میسنجد که پژوهش، تحلیل و تولید سند را در قالب یک وظیفه طولانی به هم متصل میکنند و آن هم بر مبنای مقیاس Elo امتیازدهی میشود. Grok 4.7 امتیاز ۱۶۵۷ را ثبت کرد، در برابر ۱۶۷۸ برای Fable 5.1. همان نتیجه، با آزمونی متفاوت.
CursorBench 4.0، بنچمارک Cursor برای وظایف واقعی کدنویسی درون ادیتور آن، دقت را در برابر هزینه و تعداد توکن مصرفشده برای هر وظیفه ترسیم میکند. Grok 4.7 در میانه قرار میگیرد: هزینه هر وظیفه آن از GPT-6 Astra، جانشین GPT-5.6 Sol، و Claude Sonnet 5 بالاتر است، اما همچنان از Fable 5.1 عقب میماند؛ مدلی که در نمودار در تمام سطوح قیمتی برنده است.
این الگو برای xAI جدید نیست. Grok 4.5 در ژوئیه با بزرگترین کلاستر آموزشی صنعت و امتیازهای رتبه سوم، پایینتر از مدلهای Claude و OpenAI، عرضه شد. پیش از آن، Grok 4.20 قابلیت اتکا را با سرعت و شخصیت معاوضه کرده بود. Grok 4.6 نیز در خودمختاری کدنویسی از گروه پیشرو عقبتر بود.
هیچیک از این موارد باعث نمیشود Grok 4.7 برای میلیونها کاربری که از طریق X، اپلیکیشن مستقل، یا داشبورد تسلای خود با آن تعامل دارند، محصول بدی باشد. معنای آن این است که مدلی که به احتمال زیاد به پرسشهای شما پاسخ میدهد یا دستیار صوتی خودرویتان را تغذیه میکند، بر سیستمی اجرا میشود که بنچمارکهای خود سازندهاش آن را یک پله پایینتر از صدر نردبان قرار میدهند.
همین فاصله است که باعث میشود برای بیشتر مردم، برچسب قیمت مهمتر از جایگاه در جدول ردهبندی باشد. xAI بهطور مستمر از نظر هزینه به ازای هر توکن، Anthropic و OpenAI را پشت سر گذاشته، حتی در حالی که از نظر توان خام از آنها عقبتر بوده است؛ با این شرطبندی که «بهاندازه کافی خوب، ارزان و همهجا حاضر» برای بخش عمده استفاده روزمره، بر «بهترین، اما گرانتر» غلبه میکند.
ماسک چند روز پیش از عرضه نیز انتظارات را پایینتر تنظیم کرده بود و نوشت که Grok 4.7 باید «تقریباً همسطح» Claude Opus 5.0 از Anthropic باشد، نه Opus 5.1 جدیدتر، و اینکه عملکرد چندوجهی آن هنوز به کار بیشتری نیاز دارد.
او در همان پست، سه مدل بعدی را نیز ترسیم کرد: Grok 4.8 بهعنوان یک گام معنادار رو به جلو، Grok 4.9 در «کلاس Astra/Fable» و Grok 5 بهعنوان یک رهبر احتمالی در مرز فناوری. این ارتقاها هنوز تاریخ عرضه ندارند. او نوشت: «خواهیم دید.»